Wissen · Künstliche Intelligenz
Eine digitale Assistenz soll nach ihrer Leistung beurteilt werden. Doch Name, Darstellung und menschliche Anmutung können bei der Bewertung mitspielen. Eine neue Untersuchung mit KI-Assistenten in einer virtuellen Arbeitsumgebung macht genau diese Frage sichtbar. Wir erklären, was die Studie zeigt und welche praktischen Fragen sich daraus für den Einsatz von KI im Team ergeben.
Die virtuelle Testumgebung
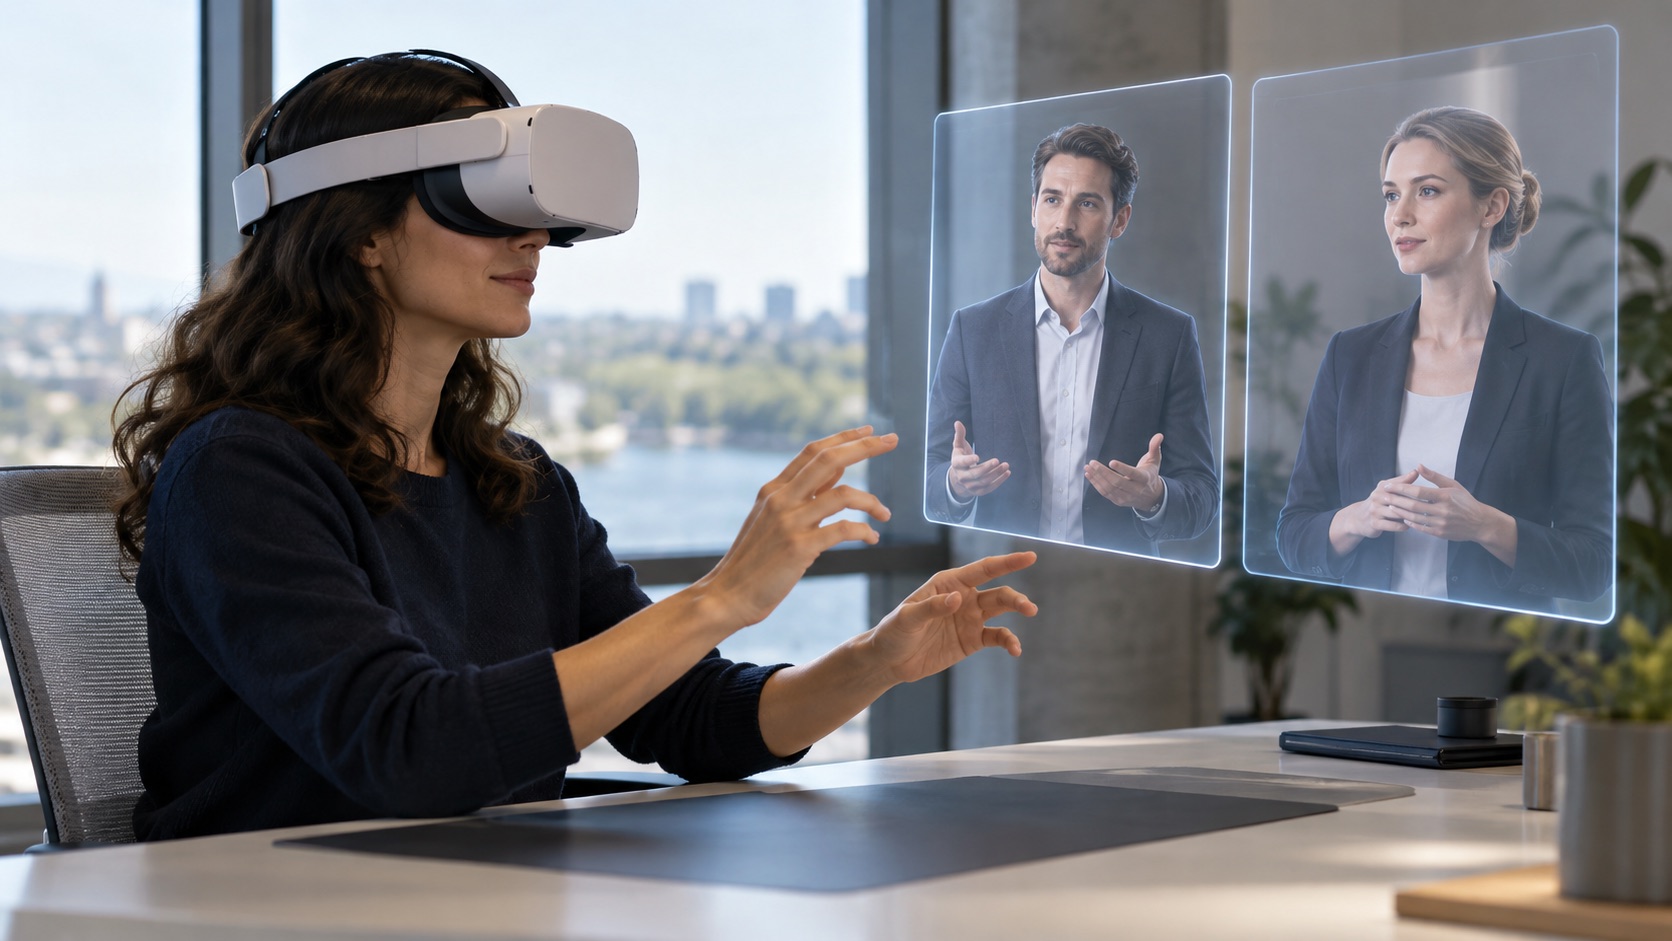
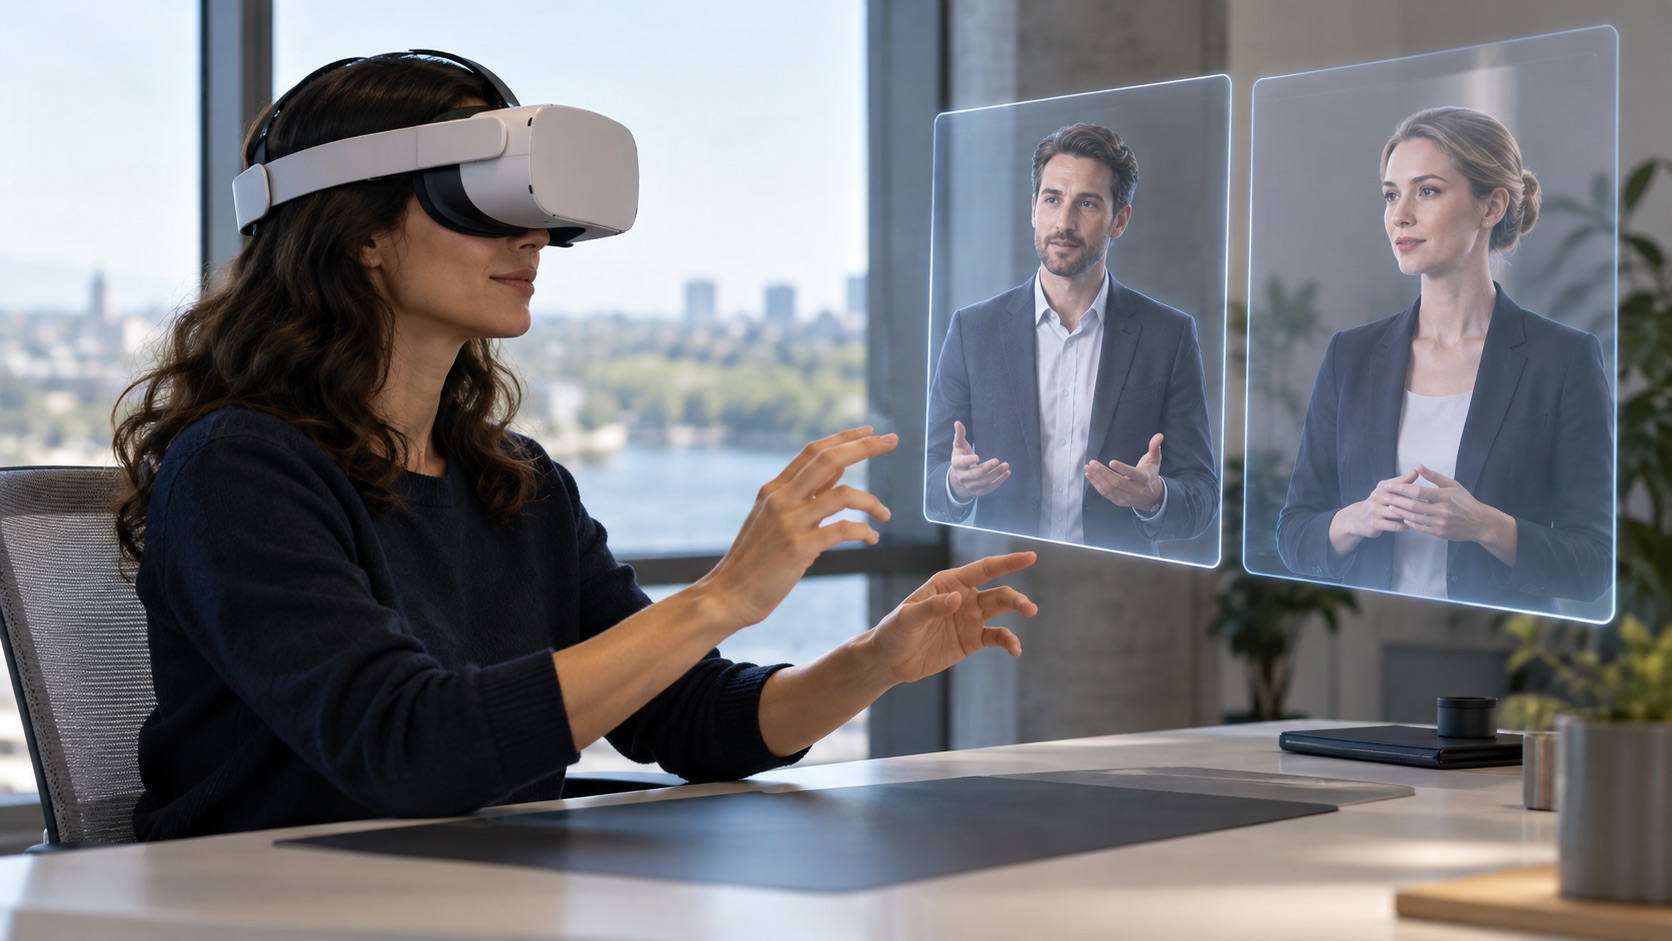
Die Studie „Human-like and male? How AI assistant design relates to trust and monetary reward at work in VR“ wurde am 3. Oktober 2026 veröffentlicht. 189 Beschäftigte aus wissensbasierten Tätigkeiten arbeiteten mit drei funktional gleichen KI-Assistenten, deren menschliche Anmutung und Geschlechtsdarstellung variierten. Sie bewerteten die Assistenten und verteilten finanzielle Belohnungen. Ergänzend führte das Forschungsteam 34 Interviews. Laut Zusammenfassung erhielt die weiblich dargestellte Assistenz weniger Belohnung als die männlich dargestellte und wurde als weniger menschenähnlich wahrgenommen.
Der veröffentlichte Abstract beschreibt außerdem einen Zusammenhang zwischen stärkerer menschlicher Anmutung und höherer Belohnung. In Interviews erklärten viele Teilnehmende dagegen, dass das Geschlecht keine Rolle spiele und sie weniger menschenähnliche Assistenten bevorzugten. Die Untersuchung betrachtet damit eine konkrete experimentelle Situation. Aus ihr folgt keine allgemeine Aussage über jede KI-Anwendung und keine Messung realer Gehälter im Arbeitsmarkt.
Co-Autor Thomas Fritz betont im Interview der Universität Zürich, dass die Ursache des Unterschieds nicht eindeutig feststeht. Für den Vergleich der menschlichen Darstellung arbeitete jeweils eine Teilnehmergruppe mit der männlich beziehungsweise weiblich dargestellten Assistenz; die Einzelnen verglichen beide nicht unmittelbar. Fritz beschreibt außerdem einen Zusammenhang zwischen wahrgenommener Menschlichkeit, Vertrauen und Belohnung. Das sind Befunde zu dieser Versuchsanordnung. Die pauschale Behauptung, jede weiblich dargestellte KI genieße grundsätzlich weniger Vertrauen, ginge darüber hinaus.
Oberfläche und Antwort trennen
Für den eigenen KI-Einsatz ist zunächst eine einfache Frage nützlich: Was genau bewerten wir? Eine sympathische Stimme, eine verständliche Darstellung und ein korrektes Arbeitsergebnis sind verschiedene Eigenschaften. Alle können relevant sein, sollten aber nicht unbemerkt zu einem einzigen Eindruck verschmelzen. Unsere redaktionelle Empfehlung ist, diese Kriterien vor einem Vergleich aufzuschreiben. Dann wird sichtbar, warum ein Werkzeug bevorzugt wird.
Nehmen wir eine Assistenz, die Besprechungen zusammenfasst. Für die fachliche Bewertung wären etwa Vollständigkeit, richtige Zuordnung von Aufgaben und nachvollziehbare Wiedergabe offener Entscheidungen wichtig. Die angenehme Gestaltung kann zusätzlich beurteilt werden. Sie sollte jedoch keine fehlende Information überdecken. Ein Team, das beide Ebenen getrennt betrachtet, kann genauer entscheiden, ob es eine andere Oberfläche oder eine bessere Funktion benötigt.
Dasselbe gilt im Kundenkontakt. Ein überzeugender Auftritt macht eine falsche Antwort nicht richtig. Andererseits kann eine sachlich korrekte Antwort unverständlich präsentiert sein. Beide Probleme verdienen eigene Maßnahmen. Wir würden deshalb die fachliche Prüfung anhand eines festgelegten Beispiels durchführen und erst danach die Bedienung beurteilen. So entsteht aus einem persönlichen Eindruck eine Entscheidung, deren Gründe sich im Team besprechen lassen.
Mit denselben Aufgaben vergleichen
Wer mehrere KI-Werkzeuge auswählt, sollte sie mit denselben realistischen Aufgaben vergleichen. Formuliere dafür eine kleine Sammlung aus dem eigenen Arbeitsalltag: eine Zusammenfassung, eine Auskunft aus freigegebenen Unterlagen und eine Antwort auf eine unvollständige Anfrage. Lege vorher fest, woran eine gute Lösung erkennbar ist. Diese Vorbereitung hilft mehr als eine freie Vorführung, bei der jedes Werkzeug seine günstigste Aufgabe zeigen darf.
Bei einer ersten fachlichen Prüfung können Antworten ohne Produktnamen und ohne Avatar vorgelegt werden. Danach lässt sich die Oberfläche gesondert ausprobieren. Das ist unsere vorgeschlagene Vorgehensweise und kein von der Studie nachgewiesenes Heilmittel gegen Vorurteile. Sie schafft aber eine nachvollziehbare Trennung der Beobachtungen. Wenn sich die Rangfolge zwischen beiden Schritten ändert, hat das Team einen konkreten Punkt für die weitere Diskussion.
Wichtig sind zudem Fehler und Grenzen. Prüfe, ob das Werkzeug fehlende Informationen erkennbar macht oder sie durch eine flüssige Formulierung ersetzt. Dokumentiere auch die Arbeit, die zur Kontrolle nötig bleibt. Ein Assistent kann im ersten Eindruck überzeugend wirken und trotzdem viel Nacharbeit verursachen. Ein anderer kann nüchterner auftreten, aber besser zum Ablauf passen. Die Entscheidung sollte diesen Unterschied sichtbar machen.
Was Teams daraus lernen können
Wir würden mit einer klar umrissenen Aufgabe beginnen und eine verantwortliche Person für die Prüfung benennen. Die Assistenz braucht keine künstliche Persönlichkeit, um ihren Zweck zu erklären. Sage dem Team, was sie leisten soll, welche Informationen sie verwendet und wann ein Ergebnis geprüft werden muss. Eine verständliche Rolle erleichtert die Einführung und verhindert, dass Erwartungen allein aus Name, Stimme oder Darstellung entstehen.
Nach einer Probephase lohnt sich eine Auswertung mit denselben Kriterien wie zu Beginn. Frage nach konkreten Fällen: Wo wurde Zeit gespart, welche Antwort musste korrigiert werden und welche Aufgabe blieb offen? Die allgemeine Frage, ob die Assistenz „gut ankommt“, kann ergänzen, sollte die fachliche Bewertung aber nicht ersetzen. Halte Unterschiede zwischen beobachteter Leistung und persönlicher Vorliebe ausdrücklich fest. Gerade diese Trennung macht die Diskussion produktiver.
Die Forschung ist für uns ein Anlass, genauer zu bewerten, keine Aufforderung zu einer bestimmten Geschlechtsdarstellung. Für den Alltag zählt ein verlässliches Werkzeug mit klaren Grenzen und einer passenden Bedienung. Wenn Teams dieselben Aufgaben, erkennbare Kriterien und überprüfbare Ergebnisse verwenden, können sie ihre Auswahl besser begründen. Dann entscheidet weniger der erste Eindruck und stärker die Frage, welche Assistenz die konkrete Arbeit tatsächlich unterstützt.